
Как выбрать сервер для ИИ в 2026 году
Сервер для ИИ — это не просто узел x86 с мощной видеокартой, а сбалансированная система, где графические ускорители, видеопамять, межсоединения, процессор, ОЗУ, NVMe, сеть, питание и охлаждение рассчитаны под конкретную нагрузку. Выбор только по поколению графического ускорителя часто приводит к переплате или узкому месту, из-за которого ускорители не используются на полную мощность.
Задачи искусственного интеллекта требуют разного железа: начинать нужно со сценария — обучение модели с нуля, файнтюнинг, инференс, компьютерное зрение или распределенный кластер. Для них различаются требования к объему и пропускной способности видеопамяти, обмену между графическими ускорителями, дискам и сети. Поэтому сначала фиксируют нагрузку и требования к эксплуатации, а затем подбирают ускоритель и серверную платформу.
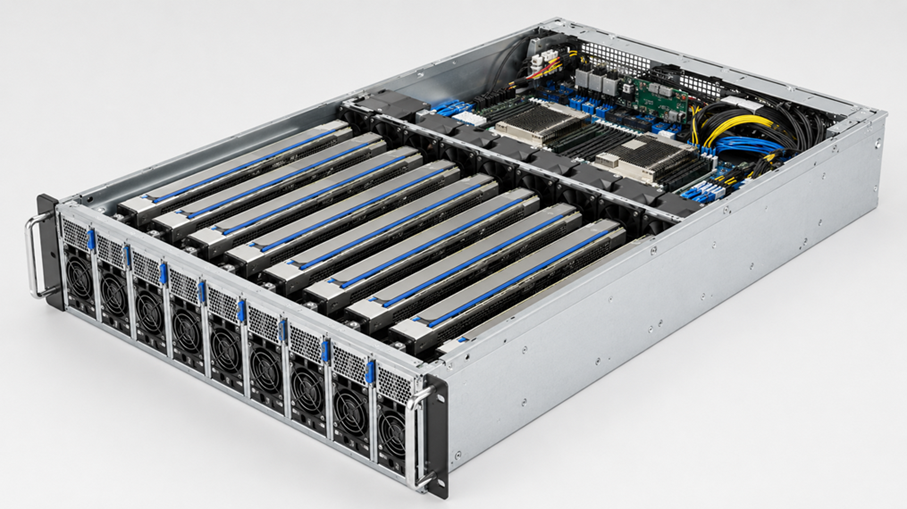
Инфраструктуру ИИ выбирают как систему: вычисления, хранение данных, сеть, питание и охлаждение должны работать согласованно
Что делает сервер «ИИ-сервером»
Главное отличие сервера для искусственного интеллекта — акцент на параллельных вычислениях, а не на последовательной обработке задач процессором. В обычном корпоративном сервере основная нагрузка часто ложится на процессор, ОЗУ и диски. В ИИ ключевыми становятся матричные вычисления, объем видеопамяти, пропускная способность памяти и обмен между ускорителями. Например, NVIDIA H200 имеет 141 ГБ HBM3e с пропускной способностью 4,8 Тб/с, а H100 SXM — 80 ГБ HBM3 и 3,35 Тб/с. Процессор при этом отвечает за ввод-вывод, подготовку данных, сеть и работу с накопителями: слабая топология PCI-E, нехватка ОЗУ или медленное хранилище способны оставить дорогие графические ускорители без работы.
Три режима: обучение, файнтюнинг и инференс
- серверы для обучения ИИ с нуля требуют максимума вычислений, HBM, быстрого обмена между графическими ускорителями и, для крупных моделей, высокоскоростной сети между узлами;
- файнтюнинг зависит от метода: полное дообучение близко к обучению по требованиям к памяти, а LoRA, QLoRA и другие PEFT-подходы могут заметно снизить ее расход;
- в инференсе важны видеопамять под веса и KV-кеш, время до первого токена, токены в секунду и число одновременных запросов. Квантизация и оптимизированные движки часто важнее перехода на самый дорогой графический ускоритель.
Сценарии применения и расчет видеопамяти
Для больших языковых моделей важны память и межсоединения, для компьютерного зрения — также видеокодеки, для RAG — скорость доступа к индексу и базе знаний, для высокопроизводительных вычислений — баланс графических ускорителей, процессора, сети и хранилища. До спецификации стоит зафиксировать размер модели, формат весов, длину контекста, батч, объем данных, число потоков и требования к уровню обслуживания.
Универсальной формулы вида «70 млрд параметров = четыре H100» нет. Только веса модели с 70 млрд параметров занимают примерно 140 ГБ в BF16 и FP16, 70 ГБ в восьмибитном и 35 ГБ в четырехбитном представлении, дополнительно нужна память для KV-кеша, активаций, среды выполнения и других структур. Поэтому две карты по 48 ГБ могут быть практичны для квантизованного инференса, но полное обучение или высокоточный инференс потребуют существенно большего запаса.
Для инференса важна не только емкость видеопамяти. vLLM поддерживает тензорный и конвейерный параллелизм, параллелизм по данным и многоузловое обслуживание, поэтому сервис можно масштабировать как более крупным ускорителем, так и несколькими экземплярами. Для RAG отдельно измеряют задержку поиска по индексу и обращения к базе знаний.
Для видеоаналитики учитывают декодирование и кодирование, разрешение, количество кадров в секунду и число потоков. NVIDIA L40S, например, имеет три NVENC и три NVDEC с поддержкой AV1. В промышленной эксплуатации также важны коррекция ошибок, мониторинг, резервирование питания и валидированное охлаждение.
Графические ускорители: что выбирать
Графический ускоритель определяет значительную часть производительности и бюджета, но выбирать его нужно вместе с форм-фактором. PCI-E дает гибкость и подходит для одного или нескольких ускорителей, SXM используется в высокоплотных NVIDIA HGX с NVLink и NVSwitch, OAM применяется, в частности, в системах AMD Instinct и требует специализированной платформы. Попытка позже превратить обычный сервер PCI-E в узел класса HGX может потребовать полной замены платформы.
Графический ускоритель — центральный вычислительный компонент системы ИИ, но его выбор всегда связан с форм-фактором, питанием, охлаждением и возможностями платформы.
NVIDIA и AMD
В 2026 году одновременно актуальны Hopper и Blackwell. NVIDIA B200 предлагает 180 ГБ HBM3e, 8 Тб/с и мощность 1 000 Вт, H200 SXM — 141 ГБ HBM3e, 4,8 Тб/с и до 700 Вт, H100 SXM — 80 ГБ HBM3 и 3,35 Тб/с. Для инференса и смешанных задач применяются ускорители PCI-E: RTX PRO 6000 Blackwell Server Edition с 96 ГБ GDDR7 с коррекцией ошибок, L40S с 48 ГБ GDDR6 с коррекцией ошибок и L4 с 24 ГБ при низком энергопотреблении.
AMD Instinct MI300X имеет 192 ГБ HBM3 и до 5,3 Тб/с, MI350X — 288 ГБ HBM3E и 8 Тб/с. Большая память на один ускоритель может уменьшить потребность в шардинге, но выбор AMD рационален только после проверки рабочего стека на ROCm. Для NVIDIA аналогично проверяют CUDA, нужные библиотеки и серверную валидацию.
|
Графический ускоритель |
Память |
Пропускная способность |
Мощность |
Формат и роль |
|
NVIDIA H200 NVL |
141 ГБ HBM3e |
4,8 ТБ/с |
до 600 Вт |
PCIe Gen5, двухслотовая карта; инференс больших языковых моделей и высокопроизводительные вычисления |
|
NVIDIA H100 PC |
80 ГБ HBM2e |
около 2 ТБ/с |
до 350 Вт |
PCIe Gen5; обучение моделей, инференс и высокопроизводительные вычисления |
|
RTX PRO 6000 Blackwell Server Edition |
96 ГБ GDDR7 с коррекцией ошибок |
1 597 ГБ/с |
400-600 Вт |
PCI-E, инференс и файнтюнинг |
|
NVIDIA L40S |
48 ГБ GDDR6 с коррекцией ошибок |
864 ГБ/с |
350 Вт |
PCI-E, инференс и видео |
|
NVIDIA L4 |
24 ГБ |
— |
72 Вт |
низкопрофильный PCI-E, энергоэффективный инференс |
Цены в сравнении намеренно не фиксируются: стоимость серверных графических ускорителей зависит от канала поставки, комплектации, гарантии, валюты и наличия. Для закупки корректнее сопоставлять коммерческие предложения на одну дату.
Для нескольких графических ускорителей критична топология обмена. H100 и H200 через NVLink обеспечивают до 900 ГБ/с на ускоритель, HGX B200 — до 1,8 Тб/с, у AMD связь внутри платформы строится на Infinity Fabric. В коммуникационно насыщенном обучении межсоединение может быть важнее небольшой разницы в вычислительной мощности.
Региональные версии, оптимизации и функции графических ускорителей
H800 и A800 создавались как экспортно-ограниченные варианты H100 и A100. На вторичном рынке встречаются разные исполнения, поэтому перед закупкой проверяют точный артикул или партномер, спецификацию, память, TDP, PCI-E и схему межсоединений. Поддержку NVLink или NVSwitch нужно подтверждать именно для выбранной карты и сервера.
Практическая производительность трансформеров зависит не только от TFLOPS, но и от типов данных и библиотечных оптимизаций. FlashAttention-2 для CUDA поддерживает Ampere, Ada и Hopper на совместимых версиях. Коррекция ошибок и MIG также различаются по модели: H100 и H200 поддерживают до семи инстансов MIG, L40S MIG не поддерживает.
Процессор, ОЗУ и хранилище
Процессор для ИИ выбирают не только по числу ядер. Важны линии PCI-E, их разводка, число каналов памяти и NUMA. AMD EPYC 9005 предлагает до 192 ядер на сокет, 12 каналов DDR5 и PCI-E 5.0 x128 у EPYC 9965, Intel Xeon 6 включает модели до 128 P-cores или до 288 E-cores. При четырех-восьми графических ускорителях нужно изучать блок-схему сервера: к какому процессору подключены ускорители и сетевые карты и есть ли коммутаторы PCI-E.
Системная ОЗУ нужна для загрузки моделей, препроцессинга, кешей и оркестрации, в продуктивной среде базовым требованием является коррекция ошибок. Объем уточняют по телеметрии и рекомендациям конкретной платформы, а каналы памяти заполняют симметрично с учетом ограничений процессора.
Хранилище подбирают по профилю доступа. Отдельный NVMe используют для ОС, быстрый пул NVMe — для горячих моделей и датасетов, отдельный пул или сетевое хранилище — для контрольных точек, жесткие диски или объектное хранилище S3 — для архива. В кластере узким местом может стать не локальный твердотельный накопитель, а сеть или серверная часть хранилища.
Серверные платформы и решения 3Logic Group
Рынок серверов для искусственного интеллекта включает готовые NVIDIA DGX, серверы на HGX, универсальные платформы PCI-E и системы OAM AMD. DGX B200 содержит восемь Blackwell и потребляет до примерно 14,3 кВт, HGX B200 — интеграционная платформа с восемью B200 и фабрикой NVLink. Среди других вариантов в исходном материале рассматриваются Dell PowerEdge XE9680, HPE ProLiant DL380a Gen11, Lenovo ThinkSystem SR680a V3 with B200, ASUS ESC8000-E12, Supermicro AS -5126GS-TRNT, xFusion G5500 V7.
|
Платформа |
Форм-фактор |
Графический ускоритель |
Типичный сценарий |
|
Dell PowerEdge XE9680 |
6U |
восемь H100 или восемь H200 либо восемь MI300X |
крупное обучение и высокопроизводительные вычисления |
|
HPE ProLiant DL380a Gen11 |
2U |
до четырех L40S или четырех H100 NVL либо восьми L4 |
инференс и файнтюнинг |
|
Lenovo SR680a V3 with B200 |
8U |
восемь B200 180 ГБ |
Blackwell HGX |
|
ASUS ESC8000-E12/ESC8000A-E13 |
4U |
до восьми H200 или RTX PRO 6000 |
плотные системы PCI-E |
Жизненный цикл ИИ-платформ меняется быстро: в исходном материале отмечено, что прежний Lenovo SR680a V3 с H100 и H200 был снят с продаж в июне 2026 года, а вариант SR680a V3 with B200 обновлялся 15 июля 2026 года. Поэтому актуальную модель и список поддерживаемых графических ускорителей нужно проверять непосредственно перед заказом.
В 3Logic Group представлены серверные ускорители NVIDIA H200 NVL 141 ГБ, L40S 48 ГБ и RTX PRO 6000 Blackwell Server Edition, а также системы Crusader Squire. Для Squire 4135R заявлена установка до восьми графических ускорителей, а конфигурация Squire 2255R включает два AMD EPYC 9535, 768 ГБ DDR5 с коррекцией ошибок, четыре NVMe U.2 по 3,84 Тб и два L40S 48 ГБ. Наличие и точную совместимость перед заказом нужно перепроверять.
Охлаждение, питание и физическая инфраструктура
Высокая мощность графических ускорителей быстро превращает выбор сервера в задачу ЦОД. B200 и MI350X достигают 1 000 Вт на ускоритель, H200 SXM — до 700 Вт. Поэтому до заказа проверяют максимальную входную мощность готового узла, схему резервирования блоков питания, возможности блока распределения питания и ИБП, тепловой профиль, поддерживаемое охлаждение, глубину и массу сервера.
Рост мощности графических ускорителей повышает требования к воздушному потоку и тепловому контуру.
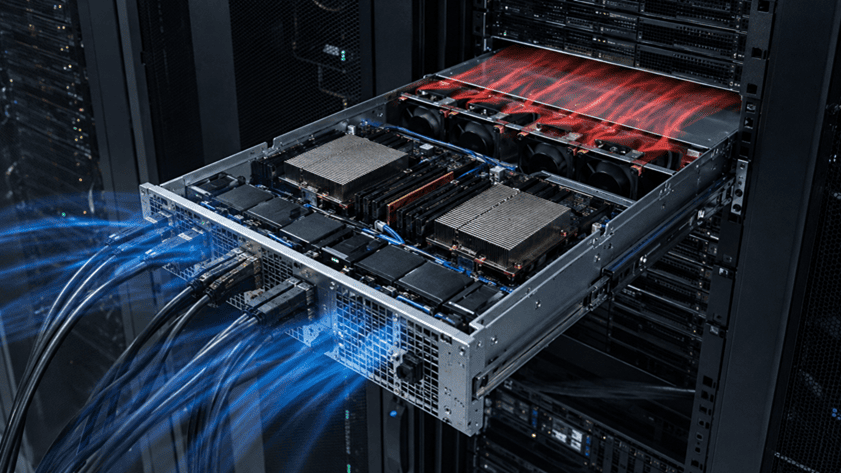
Тип охлаждения необходимо согласовать с поддерживаемой конфигурацией производителя и возможностями ЦОД.
Универсального порога, после которого обязательно жидкостное охлаждение, нет. Воздушная схема требует разделения холодных и горячих потоков и достаточной производительности CRAC и CRAH, жидкостная — CDU, трубопроводов, контроля утечек и сервисного доступа. Ориентиром должна быть конфигурация, поддерживаемая производителем.
Питание считают по максимальной мощности сервера, а не по сумме TDP. Для стойки суммируют серверы, сеть, СХД и вспомогательные устройства, проверяют ток, напряжение, разъемы и резервирование по вводам, затем подтверждают расчет нагрузочным тестом. Для тяжелых систем также заранее проверяют высоту в U, глубину шкафа, массу на стойку и возможности заноса оборудования.
Сеть: InfiniBand или Ethernet
Если модель помещается в одном узле, достаточно сети, которая закрывает трафик данных и сервисов. При распределенном обучении коммуникация становится частью критического пути. NVIDIA Quantum-2 InfiniBand поддерживает до 400 ГБит/с и RDMA и GPUDirect, для Ethernet применяются 400GbE, RoCE и Spectrum-X. InfiniBand логичен для выделенного кластера обучения, Ethernet — при сильной существующей экспертизе и корректно настроенной сети без потерь. Покупать 400 ГБит/с каждому серверу без профилирования не стоит.
Программный стек и мониторинг
Совместимость ОС, ядра, драйвера, CUDA или ROCm, контейнерной среды и фреймворка — часть аппаратного проекта. В исходном материале как практичные базовые ОС рассматриваются Ubuntu 22.04 LTS и 24.04 LTS. В Kubernetes NVIDIA GPU Operator автоматизирует установку драйверов и плагинов на поддерживаемых платформах, для AMD используются инструменты экосистемы ROCm. Наличие общей фразы «поддерживает Linux» не заменяет проверку конкретных версий.
NVIDIA-Certified Systems снижает интеграционный риск, но не отменяет тест реальной нагрузки. Для AMD проверяют матрицу ROCm, конфигурацию производителя и поддержку драйверов. При выборе между CUDA и ROCm составляют список реально используемых библиотек: стоимость портирования проприетарных CUDA-расширений должна входить в совокупную стоимость владения.
После запуска постоянно собирают загрузку графических ускорителей и видеопамяти, температуру, энергопотребление, события коррекции ошибок и Xid и, при необходимости, счетчики NVLink, NVSwitch и сети. NVIDIA DCGM и dcgm-exporter передают телеметрию в Prometheus, Grafana используется для визуализации и предупреждений. Пороги задают по документации конкретного ускорителя, а не по универсальному значению температуры.
ИИ в продуктивной среде требует постоянного контроля телеметрии: загрузки графических ускорителей, памяти, температуры, энергопотребления и аппаратных ошибок.
Для разделения ресурсов используют MIG там, где он поддерживается: H100 и H200 позволяют создавать до семи инстансов, L40S MIG не поддерживает. Альтернатива — Kubernetes, очереди задач, квоты и отдельные реплики инференса.
Как выбрать конфигурацию под нагрузку
Правильный порядок: определить модель и режим → оценить минимальную видеопамять → выбрать графический ускоритель и формат → проверить процессор, ОЗУ, NVMe и сеть → подтвердить питание и охлаждение → провести проверку концепции.
Бюджетный старт
Башенный сервер или рабочая станция подходит для прототипирования, локального RAG и квантизованного инференса. RTX 4090 с 24 ГБ GDDR6X годится для исследований, но не имеет NVLink и не заменяет серверный ускоритель по коррекции ошибок, валидации, охлаждению и управляемости.
Умеренные и средние нагрузки
Для продуктивного пилота обычно рассматривают один-два L4, L40S, RTX PRO 6000 Blackwell Server Edition или H200 NVL, 256-512 ГБ ОЗУ с коррекцией ошибок и быстрый NVMe. Для нескольких моделей и смешанного обучения — четыре-восемь валидированных графических ускорителей, от 512 ГБ ОЗУ, несколько NVMe и сеть 100-400 ГБит/с по результатам профилирования.
Высокие нагрузки
Для полного обучения больших моделей и фабрик ИИ проектируют не отдельный сервер, а кластер: узлы HGX или OAM, высокоскоростную фабрику 400 ГБит/с, общее хранилище, планировщик, мониторинг и резервирование. Мощность и охлаждение стойки проверяют до определения числа узлов.
Чек-лист перед покупкой
- какой основной режим: обучение, файнтюнинг, инференс, компьютерное зрение или смешанная нагрузка;
- каков размер модели, точность, контекст и минимальная видеопамять с учетом накладных расходов;
- нужны ли NVLink, NVSwitch, Infinity Fabric или достаточно PCI-E;
- поддерживает ли конкретный сервер выбранный графический ускоритель, питание и охлаждение;
- проверены ли CUDA или ROCm и критичные библиотеки на целевой ОС;
- какова максимальная входная мощность узла и выдержат ли ее блок распределения питания и ИБП;
- поддерживает ли ЦОД требуемый воздушный или жидкостный контур;
- проходят ли масса, глубина, высота в U и направляющие по ограничениям площадки;
- есть ли понятный путь масштабирования графических ускорителей, сети и хранилища;
- как устроены гарантия, сервис, запасные части и обновления;
- совместимы ли ОС, ядро, драйверы, контейнерная среда и оркестрация;
- предусмотрено ли резервирование питания, сети и данных в соответствии с требованиями к уровню обслуживания.
Заключение
Лучший сервер для искусственного интеллекта — не самый мощный в прайс-листе, а тот, который соответствует реальной нагрузке и может эксплуатироваться без узких мест. В 2026 году одновременно используются Hopper, Blackwell и AMD Instinct, а программный стек меняется еще быстрее. Поэтому важнее не абстрактный «запас на пять лет», а проверенный путь обновления: стандартизированные контейнеры, поддерживаемые драйверы, масштабируемая сеть, сервис и платформа, которую можно расширять без технологического тупика.
Каждый проект следует оценивать не только с технической точки зрения, но и с учетом фактической доступности ускорителей, серверных платформ и комплектующих у конкретного производителя и поставщика. Наличие, доступные конфигурации и сроки поставки могут меняться, поэтому их необходимо подтверждать непосредственно перед закупкой. После согласования подходящего решения ориентироваться стоит на срок действия актуального коммерческого предложения.
Часто задаваемые вопросы
Какой графический ускоритель подходит для обучения в 2026 году?
Для крупного обучения ориентиры — NVIDIA H200 и B200 и AMD MI300X и MI350X. Финальный выбор зависит от модели, точности, фабрики и совместимости CUDA или ROCm и должен подтверждаться тестом.
Чем ИИ-сервер отличается от обычного?
Наличием ускорителей и инфраструктуры, которая позволяет использовать их без узких мест: видеопамяти, быстрых межсоединений, PCI-E, ОЗУ, NVMe, сети, питания и охлаждения.
Сколько видеопамяти нужно для модели с 70 млрд параметров?
Только веса занимают около 140 ГБ в BF16 и FP16, 70 ГБ в восьмибитном и 35 ГБ в четырехбитном формате. Дополнительно нужна память под KV-кеш, батчинг и среду выполнения.
NVIDIA или AMD?
NVIDIA сильна зрелостью CUDA и выбором валидированных платформ, AMD Instinct — большим объемом HBM. Решение зависит от библиотек и стоимости миграции рабочего стека.
Как рассчитать питание?
Использовать максимальную входную мощность готового сервера из спецификации производителя, учесть резервирование, блок распределения питания и ИБП, а после установки подтвердить расчет нагрузочным тестом.
Можно ли использовать RTX 4090?
Да, для проверки концепции и исследований, если 24 ГБ достаточно. Для длительной продуктивной эксплуатации серверные графические ускорители безопаснее по коррекции ошибок, охлаждению, валидации и гарантийной модели.


